2013年12月27日金曜日

グループ内連番をふる方法。


グループ内連番をふる機会はすごく多いと思うので、まとめてみました。


サンプルデータ

data DT1;
input SUBJID$ V$;
cards;
001 a
001 b
001 c
002 x
002 y
;


求めたい結果
「SUBJID」毎に「V」の順番で連番をふる。


データステップで連番をふる

*** 方法1 **********;
proc sort data=DT1; by SUBJID V; run;

data OUT1;
  set DT1;
  by SUBJID V;

  if first.SUBJID then SEQ=0;
  SEQ+1;
run;

*** 方法2 **********;
proc sort data=DT1; by SUBJID V; run;

data OUT1;
  set DT1;
  by SUBJID V;

  SEQ+1-first.SUBJID*SEQ;
run;


・方法1が一般的なやり方だと思う。
・方法2は仕組みを理解すれば1行で書けるのでおススメ。


📝注意点

今回のテクニックの中で使用している「FIRST.BY変数」は「サブセット化IF」と一緒に使用すると正しく動かない事があります。
(解説記事:「サブセット化IFでありがちな落とし穴」)


2013年12月26日木曜日

SQL「再マージ」入門


「再マージ」は、SAS特有の機能っぽい。
AccessやMySQLで試してみたけど、ダメだった。

以下まとめてみてみました。


①サンプルデータ作成

data DT1;
  input A B;
cards;
1 10
1 20
1 30
2 40
2 50
;
run;


②まずは通常のSQL文

* Aのグループ毎に、Bの最大値を求める ;
proc sql;
  create table  DT2 as
  select  A, max(B) as B2
  from    DT1
  group by  A;
quit;


③「再マージ」を利用したSQL文

proc sql;
  create table DT3 as
  select  A, max(B) as B2, B
  from    DT1
  group by  A
  order by  A, B;
quit;

※ 赤字が②から追記した文。


解説
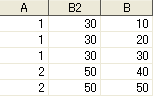
(1) まず②と同様、Aのグループ毎に、Bの最大値を求めにいきます。


(2) がしかし、select文にはBも指定されています。
そのため以下の元データ「DT1」からBを取ってきて、上記(1)とマージします。


(3)Aのグループ毎に(1)での計算が(2)にマージされます。
出来上がりは、DATAステップの「merge (1)(2); by A」とした時みたいな感じ。(内部処理の動きは違うと思うけど。)


ちなみに、この「再マージ」が行われると、並び順が狂うので、「order by A、B」と並び替えをしています。


ちょっと説明が分かりづらいかもしれないけど、
この仕組みは便利なので、今後活用法を小出ししていこうと思います。

2013年12月24日火曜日

ログに独自のエラーメッセージを表示する。


ログのメッセージは、
「NOTE」「WARNING」「ERROR」の3種類あり、

以下サンプルのように上記キーワードとコロン(:)をつけてPUTすると
ログ上に色つきの独自メッセージを表示できます(キーワードは大文字で記述すること)


サンプルプログラム
data _null_;
  put "NOTE:    独自メッセージ1";
  put "WARNING: 独自メッセージ2";
  put "ERROR:   独自メッセージ3";
run;


ログ


ただし、あくまでNOTE・WARNING・ERRORメッセージっぽい表示をしているだけです。
例えば、この方法でERRORメッセージを出したからといって、データステップを中止させるとか、処理に影響を与える事が出来るわけではありません。


使用例として、以下のように条件によって注意喚起を促したい場合に使える。

*** サンプルデータ ;
data DT1;
input SUBJID$ AGE;
cards;
001 17
002 21
003 16
;
run;

*** 年齢が18歳未満だったら、WARNINGメッセージを表示 ;
data DT2;
 set DT1;
 if AGE<18 then put "WARNING: 18歳未満です。" SUBJID= AGE=;
run;


ログ


自分の書いたメッセージがログに色つきで出るのがなんか楽しい。

2013年12月20日金曜日

PUT関数 vs VVALUE関数


以下のように、「PUT関数」を使って文字変換することってよくありますよね。

*** サンプルデータ *******************;
data DT1;
  format   V1 yymmdd10. ;
  V1 = '01jan2000'd; output;
  V1 = '05feb2001'd; output;
  V1 = .; output;
run;

*** PUT関数を使って文字化 ***********;
data DT2;
  length V1 8.  V2 $20.;
  set DT1;
  V2 = put(V1,yymmdd10.) ;
run;


これは「VVALUE関数」でもっと簡単に書けます。

 V2 = VVALUE(V1) ;

「VVALUE関数」は「変数に割り当てられているFORMAT」を使って文字変換してくれる関数です。


注意点


PUT関数と挙動が似ています。
例えば、PUT関数で数値の欠損値を以下のようにFORMAT変換すると、、

 length V3 $20.;
 V3 = put( . , yymmdd10.);

→ 変換後の値は「         .」という感じで先頭に余計な空白が入ります。


また、フォーマットによっては、、

 length V4 $20.;
 V4 = put( 10, best12. );

→ 変換後の値は「          10」という感じでこちらも先頭に余計な空白が入る場合があります。


VVALUE関数も同様に先頭に空白が入る場合があるのでご注意下さい。


2013年12月16日月曜日

全角文字を半角に変換する。


全角から半角へ、半角から全角へと変換する「KPROPCASE関数」についてまとめてみました。


構文

KPROPCASE( 対象変数名,  ' 変換パターン指定 ' )

変換パターン 指定方法
① 全角カタカナ ⇒ 半角カタカナ'full-katakana, half-katakana'
② カタカナ ⇒ ローマ字'katakana, romaji'
③ 全角アルファベット ⇒ 半角アルファベット

(英数記号も対象。
 ただし全角中点「・」は半角にならなかった。
 ①の指定方法では半角になった)
'full-alphabet, half-alphabet'


④ 小文字 ⇒ 大文字'lowercase, uppercase'


変換パターンは、以下のように逆指定も可。

例:
kpropcase( 対象変数名,  'lowercase, uppercase' )
kpropcase( 対象変数名,  'uppercase, lowercase' )


変換例

data DT1;
  length VAR1 A B C D $30.;
  VAR1 = "あカキ(1abC";
  A = kpropcase( VAR1, 'full-alphabet, half-alphabet' ) ;
  B = kpropcase( VAR1, 'lowercase, uppercase' ) ;
  C = kpropcase( VAR1, 'half-katakana, full-katakana' ) ;
  D = kpropcase( VAR1, 'katakana, romaji' ) ;
run;

結果
VAR1あカキ(1abC
A あカキ(1abC
B あカキ(1ABC
C あカキ(1abC
D あKAKI(1abC


注意

①ふたつめの引数は 「'lowercase', 'uppercase'」ではなく「'lowercase, uppercase'」です。
間違えやすいので注意が必要です。


②半角を全角に変換したい場合、
たとえば以下のプログラムを実行すると、VAR1の値は全角”A”となる。

data DT3;
  length VAR1 $2.;
  VAR1 = "AB";
  VAR1 = kpropcase( VAR1, 'half-alphabet, full-alphabet' );
run;


これは全角変換したことによって、LENGTHが4バイト必要なのに、2バイトしかないため、文字切れを起こしているから。そのため、変換前にLENGTHを2倍に指定し直す必要がある。

(※上記はWindowsのsjis環境での話で、他の環境ならもっとLENGTHが必要)

2013年12月13日金曜日

SQLの小技「CALCULATEDキーワード」


SASのSQL独自の便利機能「CALCULATED」キーワード
MySQLとかでは動かなかった。

このキーワードを使うと、SELECT句で作成した変数を、同じSQL内で参照することが出来る。


*** サンプルデータ ;
data DT1;
   do V1=1 to 3 ;
      output;
   end;
run;


*** 普通は以下のエラーが出る ;
proc sql;
  select sum(V1) as V2 ,
            V2+1 as V3
  from DT1;
quit;

ERROR: 次の列はテーブル内に存在しません: V2.


*** 「CALCULATED」を使った場合 ;
proc sql;
  select sum(V1) as V2,
           calculated V2+1 as V3
  from DT1;
quit;


正直この例だと、「sum(V1)+1 as V3」と書いてもいいけど、、
・「V2」の式が長文の場合、「V3」作る時にもう1回長文かく手間が省けていい。
・内部の処理効率的に「calculated」を使った方がいいのかも。

という理由で、個人的には「calculated」を愛用してる。

2013年12月10日火曜日

欠損値のチェックを簡単に行う。


「CMISS関数」は、欠損値の数をカウントしてくれます。
数値変数・文字変数、どちらも指定可能です。

ロジカルチェックやデータクリーニングの際に重宝します。
以下に使用例をまとめてみた。


サンプルデータ

data DT1;
input X1 X2 X3$;
cards;
1 2 aa
3 . bb
5 . .
. . .
;
run;


使用例

/* 欠損値の数を取得 */
data DT2;
  set DT1;
  Y = cmiss(X1,X2,X3);
run;


/* いずれかが欠損値のOBSを特定 */
data DT3;
  set DT1;
  if cmiss(X1,X2,X3) > 0 then FLG=1;
run;


/* すべて欠損値のOBSを特定 */
data DT3;
  set DT1;
  if cmiss(X1,X2,X3) = 3 then FLG=1;
run;