ラベル プロシジャ: SORT の投稿を表示しています。 すべての投稿を表示

2020年2月29日土曜日

[PROC SORT] オブザベーションの並べ替え(ソート)


SORTプロシジャで、オブザベーションの並べかえをすることが出来ます。


構文

PROC  SORT   DATA=対象データセット名   OUT=出力データセット名;
     BY   変数1  変数2 ...;
RUN;


「DATA=」のデータセットを「BY」に指定した変数値順にオブザベーションを並べ替え、結果を「OUT=」に指定したデータセット名で出力します。


重要なポイント


例

/* Sample */
data test;
input a b c$;
cards;
2 1 aa
2 2 bb
1 2 cc
1 1 dd
;
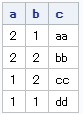


/* PROC SORTの例 */
proc sort data=test out=test2;
   by a b;
run;


2019年6月12日水曜日

データセット間で変数の順番を比較する方法


以下をご覧ください。


サンプルデータ

data A;
    X=1;
    Y=2;
    Z=3;
run;

data B;
    X=1;
    Z=3;
    Y=2;
run;


データセット A と B は、同じ変数 X, Y, Z を持っています。
しかし変数の順番が異なります(YとZの順番)


このように2つのデータセット間で変数の順番が異なっていないか、確認したいことがあります。

例えば、治験のCDISC対応を例にとると、SDTMやADaMのデータセットをダブルプログラミングで作ってPROC COMPAREして「一致したからOKね」で終わらせてしまいがちですが、変数の順番が一致してるかまではPROC COMPAREは見てくれません。


てことで、変数の順番を比較する方法を提案したいと思います。


PROC SORTでの解法例

proc sort data=sashelp.vcolumn out=_null_ uniqueout=OUT1 nouniquekey sortseq=linguistic(strength=primary);
   by name varnum;

   /*以下対象のライブラリ名とデータセット名は大文字で指定する*/
   where libname="WORK" and memname in ("A","B");
run;

proc print data=OUT1 noobs label;
   var libname memname name varnum;
run;


結果がデータセットOUT1に出力されます。
「Y」と「Z」の順番が異なっていることが分かりますね。


やってること自体は、以下記事のテクニックの焼き直しなので、こちらもご参照下さい。
https://sas-boubi.blogspot.com/2019/02/blog-post_35.html

プログラム青文字部分にチェック対象のライブラリ名とデータセット名を指定します。


2019年2月14日木曜日

データセット間で同じ変数名があるかチェックする方法


たまにタイトルにあるようなチェックをかけたい事ってありますよね。
色々方法はあると思いますが、今回はPROC SORTによる解法を載せておきます。


サンプルデータ

data TEST1;
   aa=1; bb=2;
run;

data TEST2;
   Aa=1; bb=2; cc=3;
run;

data TEST3;
   bb=2; xx=4;
run;


ここで、WORKライブラリのデータセットTEST1、TEST2、TEST3に同じ変数名があるかを確認したいと思います。


PROC SORTでの解法例

proc sort data=sashelp.vcolumn out=OUT1 nouniquekey sortseq=linguistic(strength=primary);
   by name;
   /* 以下対象のライブラリ名とデータセット名は大文字で指定する */
   where libname="WORK" and memname in ("TEST1","TEST2","TEST3");
run;


結果がデータセットOUT1に出力されます。
「aa」と「bb」が変数名として重複してるってことですね。


ざっくり解説

  • 変数定義情報は「SASHELP.VCOLUMN」から取得しています。
  • PROC SORTの「NOUNIQUEKEY」をうまく利用しています。
  • 「SORTSEQ=なんちゃらかんちゃら」の部分はマニュアル分かりづらくてちゃんと調べきれてないですが、これを指定すると日本語をソートする場合だと「あ」と「ア」、「ア」と「ア」、「B」と「b」などを同じとみなすようになります(※すべての環境で日本語が左記に書いたような挙動となるかは未確認)
  • 今回の場合は変数名が大文字だったり小文字だったりしても同じものとみなしたいんで指定してます。
  • プログラム青文字部分にチェック対象のライブラリ名とデータセット名を指定します。


2016年1月18日月曜日

SORTプロシジャによる降順ソートの便利技


サンプルデータ

data DT1;
input A$ B C$ @@;
cards;
001 1 a 001 1 b 001 2 c 002 1 a 002 2 b
;


通常の降順ソート


変数A, B, Cをキーに、オブザベーションを降順ソートしたい場合、
以下のようにdescendingオプションを変数名の前につけます。

proc sort data=DT1;
   by descending A descending B descending C ;
run;


KEYステートメントを使うと。。


上のようにdescendingオプションを全ての変数に指定するのって面倒だなーと思いませんか?
そんな時はKEYステートメントが便利です。

proc sort data=DT1;
   key A B C / descending ;
run;


これはBYステートメントと同様の機能を持ってるうえ、
  • 「KEY  変数名1 変数名2 … / オプション ;」

というように指定した変数すべてにオプションを適用する事ができるんです。


ちなみに変数Aを昇順かつ、B,Cを降順でオブザベーションをソートしたい場合、以下のように書くことも出来ます。

proc sort data=DT1;
   key A ;
   key B C / descending ;
run;


2014年9月2日火曜日

変数定義書を自動でチェックするプログラムを作ってみる。


SASデータセットの変数定義書を、以下のような感じでExcelで作ってたとする。


今回、SASを使ってこの変数定義におかしなところがないかチェックしてみたいと思います。

準備: まずEXCELのDB定義書を読み込む

読み込むプログラムは割愛。
(Excelを読み込む方法はなんでも良いのですが、文字切れやデータの欠落などが起きやすく、確実に読み込める方法がないので要注意)

仮にExcelファイルを読み込んで、以下SASデータセットDEFINEを作成したとします。

データセットDEFINE
F1 
F2 
F3
F4
F5
F6
F7 
 1
 DEMO    
 PATNO    
 被験者No    
 C    
 10    
     
 2
 DEMO    
 1BIRTH    
 生年月日    
 N    
 8    
 YYMMDDS10 
 3
 DEMO    
 AGE    
 年齢 
 N    
 8    
     
 4
 DEMO    
 AGE    
 発症年月日    
 N    
 8    
 YYMMDDS10 
 5
 AE    
 PATNO    
 被験者No    
 C    
 10    
     
 6
 AE    
 AENO    
 有害事象No    
 N   
 8   
     
 7
 AE   
 AETERM  
 有害事象名   
 C    
 20    


*** チェック①:変数名がおかしい ;
data CHECK1;
   set DEFINE;
   CHECK = NVALID(F3, "V7");
   if CHECK=0 then  put "WARNING: 変数名がおかしいです No." F1 F2 F3 ;
run;

ログ
WARNING: 変数名がおかしいです No.2 DEMO 1BIRTH
WARNING: 変数名がおかしいです No.7 AE AETERM


*** チェック②:データセット内で変数名が重複してる(SAS9.3以上でのみ動作) ;
proc sort data=DEFINE out=CHECK2 nouniquekey;
   by F2 F3;
run;

data _NULL_ ;
   set CHECK2;
   put "WARNING: 変数名が重複しています No." F1 F2 F3;
run;

ログ
WARNING: 変数名が重複しています No.3 DEMO AGE
WARNING: 変数名が重複しています No.4 DEMO AGE


解説

チェック①
NVALID関数は、指定した文字がSAS変数名として有効かどうか検証をしてくれる関数です (こちら参照)

今回の結果で最初のWARNINGは変数名が「1BIRTH」となってて、変数名の先頭は数値を入れちゃダメというルールを破ってます。
2つ目のWARNINGは変数名が「AETERM」で、よく見ると先頭が全角の「A」です。
変数名に全角はダメというルールだけど、たまにやっちゃうミスなんですよね。


チェック②
SORTプロシジャのNOUNIQUEKEYはSAS9.3から追加された機能で、BY値が重複しているレコードを抽出してくれる (こちらを参照)


もっと細かくチェックするプログラムを組むことが出来るかと思いますが、、
長くなりそうなので今回はNVALID関数の紹介も出来たことだし、とりあえずここまでとしたいと思います。


2014年3月6日木曜日

SORTプロシジャの「NODUP」と「NODUPKEY」の違い。


昔、「NODUP」を「NODUPKEY」の省略形だと勘違いして使ったら、思ったとおりの動きをしてくれなくて困ったことがありました。 

今回は「NODUP」と「NODUPKEY」を混同しないようにするための注意喚起になります。
「NODUP」は、最新のリファレンスから記載が削除されていたので詳しい挙動は不明。利用は非推奨。


例

* Sample data ;
data DT1;
input A B$;
cards;
1 a
1 b
1 a
;

A B 
  1  
  a  
  1  
b  
  1
a  

* 「NODUP」を使ってみる ;
proc sort data=DT1 out=DT2 nodup;
  by A;
run;

期待した結果
A B 
  1  
  a  

↓

実際の結果
A B 
  1  
  a  
  1  
b  
  1
a  


解説

①「NODUP」は「NODUPRECS」を省略した書き方です。

これは、
BY変数で並べ替えた後、1つ前のレコードが全変数同じ値だったら、現レコードを削除する。
という動きをします。

②ここで注意するのは、
全変数同じ値のレコード(サンプルデータでは1行目と3行目)が存在していても、
BY変数で並べ替えた後、前後にレコードが隣り合っていないと削除していない点です。


似たオプション「NODUPKEY」の詳細は以下のリンクを参照下さい。
SORTプロシジャで重複レコードを削除・抽出する。


SORTプロシジャで重複レコードを削除・抽出する。


SORTプロシジャで重複レコードを削除・抽出するオプション「NODUPKEY」と「NOUNIQUEKEY」を紹介したいと思います。


サンプルデータ

data DT1;
input A B C$ @@;
cards;
1 1 a 1 2 a 2 1 c 2 1 b
;
 A 
 B  
 C  
  1     1     a  
  1    2  a 
  2    1  c   
  2    1  b   


例①

proc sort data=DT1 nodupkey out=DT2 dupout=DT3;
  by A B;
run;

DT2
 A 
 B  
 C  
  1     1     a  
  1    2  a 
  2    1  c 


DT3
 A 
 B  
 C  
  2     1  b   


解説

  • 「NODUPKEY」を指定すると、BY変数が重複してるレコードがあった場合に、最初のレコードのみ残して、以降の重複レコードを削除してくれる。
  • 「OUT=」のデータセットには削除後のレコードが入る。
  • 「DUPOUT=」のデータセットには削除したレコードが入る。
  • 「OUT=」を省略すると、「DATA=」のデータセットに上書きしてしまうので、注意!


例② (SAS9.3からの機能)

proc sort data=DT1 nouniquekey out=DT4 uniqueout=DT5;
  by A B;
run;

DT4
 A 
  B  
 C  
  2    1   c  
  2  1  b 


DT5
 A 
  B  
 C  
  1    1   a  
  1  2  a


解説

  • 「NOUNIQUEKEY」を指定すると、BY変数が重複してるレコードと、重複していないレコードを分割することが出来る。
  • 「OUT=」のデータセットには重複してるレコードが入る。
  • 「UNIQUEOUT=」のデータセットには重複してないレコードが入る。
  • 「OUT=」を省略すると、「DATA=」のデータセットに上書きしてしまうので、注意!


「NOUNIQUEKEY」 は結構助かる機能ですね。